RAG 原理
现在主流的 RAG 方案都是使用全文检索结合向量检索的混合检索方案,兼顾关键词和语义的匹配效果。
混合检索完整流程
在真实的 RAG 场景中,用户提问的表达方式千变万化:有人用精确的专有名词 / 编号(如 “GPT-4o”、”错误码 5000000”),有人用口语化的语义描述(如 “模型答非所问怎么办”)。单一检索方式都存在盲区,因此当前业界主流方案(Elasticsearch、Milvus、阿里云 AnalyticDB、Azure AI Search、Google Vertex 等)几乎都采用混合检索(Hybrid Search):让全文检索与向量检索并行召回,再用融合算法统一排序,兼顾”关键词精确”与”语义理解”。
| 对比维度 | 全文检索(稀疏 / 关键词) | 向量检索(稠密 / 语义) | 混合检索 |
|---|---|---|---|
| 核心原理 | 倒排索引 + BM25 打分 | Embedding + 近似最近邻(ANN) | 两路并行召回 + 融合重排 |
| 擅长场景 | 专有名词、编号、ID、精确短语 | 近义词、错别字、口语化、跨语言语义 | 精确与语义兼顾 |
| 主要短板 | 同义词 / 错别字容易漏召回 | 专有名词 / 缩写 / ID 容易失准 | 架构与调参更复杂 |
| 典型算法 | BM25 / TF-IDF | HNSW + 余弦相似度 | RRF 倒数排名融合 |
完整流程总览
flowchart TD
  Q[用户 Query] --> R[可选:Query Rewrite]
  R --> M[可选:元数据过滤]
  M --> P1[全文检索路: 分词 / 倒排索引 / BM25 打分]
  M --> P2[向量检索路: Embedding / HNSW / 余弦相似度]
  P1 --> R1["结果列表 A (按 BM25 分数排序)"]
  P2 --> R2["结果列表 B (按相似度排序)"]
  R1 --> F[RRF 融合重排]
  R2 --> F
  F --> TK[Top-K 候选]
  TK --> RR[可选: Rerank 精排]
RR --> LLM[拼接上下文 到 LLM 生成答案]- 离线建索引:文档切分成 chunk 后,同一份内容同时写入两类索引——倒排索引(供 BM25 使用)与向量索引(供 KNN 使用),向量由 Embedding 模型离线算好。
- 在线双路召回:一条 Query 同时发起全文检索与向量检索,各自返回一个按自身分数排序的结果列表。
- 融合重排:两路分数量纲不同(BM25 无固定上界、余弦相似度在 0~1 之间),无法直接相加,因此用 RRF 只按排名融合成一个统一列表。
- 精排(可选):对融合后的 Top-K 用 Cross-Encoder / Reranker 做二次精排,进一步提升头部相关性。
- 生成:把最终 Top-N chunk 拼进 Prompt,交给 LLM 生成带出处的答案。
💡 RRF(Reciprocal Rank Fusion,倒数排名融合): score(d) = Σ 1 / (k + rank_i(d)),其中 rank_i(d) 是文档 d 在第 i 路结果中的排名(从 1 开始计数),k 为平滑常量(Elasticsearch 默认 60)。它不依赖原始分数、只看排名位次,天然规避了不同检索器分数无法归一化的难题;文档在越多路里排名越靠前,最终得分越高,是目前 ES 混合检索的标配方案。
向量检索
向量检索又称语义检索 / 稠密检索,先用 Embedding 模型把文本映射成高维空间里的一个点(稠密向量),语义相近的内容在空间里距离更近。检索时把 Query 也向量化,找出距离最近的若干文档,从而实现”理解意思”而非”匹配字面”。
核心原理:Embedding + 相似度
Embedding 模型(如 bge、text-embedding-ada-002)把每段文本转成固定维度的向量(如 768 / 1536 维)。两个向量的余弦相似度越接近 1,语义越相近。这让”模型答非所问” 也能召回到 “幻觉 / 输出不相关” 这类没有共同关键词、但语义一致的文档。
flowchart LR
  Q[用户 Query: 模型答非所问] --> E[Embedding 模型]
  E --> QV[查询向量]
  DOC[文档 chunk] --> E2[Embedding 模型 离线]
  E2 --> IDX[向量索引 HNSW]
  QV --> ANN[近似最近邻搜索 余弦相似度]
  IDX --> ANN
  ANN --> TOPK[Top-K 最相似文档]
检索流程
- 离线向量化建索引:每个文档 chunk 经 Embedding 模型算出向量,写入向量索引(HNSW)。
- Query 向量化:用同一个 Embedding 模型把用户查询转成查询向量。
- 近似最近邻(ANN)搜索:在向量索引中快速找出与查询向量距离最近的 Top-K 个文档。
- 按相似度返回:以余弦相似度从高到低排序返回。
文档切块
离线构建向量索引的第一步是文档切块,为什么要做切块,原因有三点:
- Embedding 模型有输入长度上限。 主流模型最大支持 512 到 8192 Token,部分模型(如 e5-mistral-7b)已支持 32k 以上,但一份产品文档动辄几万字,塞满了也是问题。
- 即使模型能处理超长文本,语义稀释也会让检索效果大打折扣。 一篇 50 页的产品文档讲了几十个功能点,Embedding 模型算出来的向量就成了这几十个功能的 “平均值”。这个平均值跟任何一个具体功能都不够接近 —— 用户搜 “退款多久到账”,向量表示里退款只占了几十分之一,检索根本抓不住。
- 即使检索回来了,送给 LLM 的内容也不该是整篇文档。LLM 的上下文窗口有限,把整篇文档塞进去既浪费 token,也会稀释真正相关的内容 ——LLM 需要的是精准的段落,不是海量的原文。
所以必须把文档切成粒度合适的段落,每个段落单独向量化,查询时匹配最相关的若干段。那切成多少合适?
- 切得太碎 —— 上下文断裂,答案可能被腰斩。 比如一份退款规则文档,用户问 “退款多久到账”,答案在文档中间。如果按固定长度机械切分,答案恰好横跨两个 Chunk 的边界,检索时两个 Chunk 各抓一半,谁都答不全。
- 切得太大 —— 回到语义稀释的问题。 一个 Chunk 塞进 2000 Token,覆盖了三四个主题,向量又变成 “平均值”,precision 下降。
切块策略
- 固定长度切块 + 滑动窗口
最朴素的做法是固定长度切块(Fixed Chunk)—— 每 500 Token 一个 Chunk,简单粗暴。
1 | |
优点:实现简单,速度快。缺点:容易在句子中间切断,破坏语义完整性。改进方案是滑动窗口(Sliding Window)——Chunk 之间有重叠:
1 | |
重叠区域让跨边界的句子至少能完整出现在某一个 Chunk 里,大幅减少信息丢失。
- 语义切块
更进一步,按文档的自然结构来切——标题、段落、小节:
1 | |
语义切块保持了每个 Chunk 的语义完整性,不会出现 “句子被腰斩” 的情况。但需要文档本身有结构(Markdown 标题、HTML 标签等),纯文本就不好使了。
- Parent-Child Chunk
现代 RAG 系统里更常见的做法是 Parent-Child Chunk:
1 | |
检索时用 Child 去搜 —— 小块粒度细,召回率高;返回时把 Parent 塞给 LLM—— 大块上下文完整,LLM 能理解全貌。兼顾了召回率和上下文完整性。
相似度计算
由于向量化模型将文本向量化成了一系列的多维向量,则可以将 “如何判断两段文本语义相关” 的问题演变成 “如何判断两个向量是否相似”。常用的向量相似度的度量算法有三种:余弦相似度、欧氏距离、点积。其中余弦相似度是绝对主流。
- 余弦相似度(Cosine Similarity)
最常用的是余弦相似度(Cosine Similarity),它比的是两个向量的方向有多接近:
1 | |
值域在 [-1, 1],1 表示方向完全一致,0 表示正交(无关),-1 表示完全相反。实践中 Embedding 模型产出的向量余弦相似度通常落在 [0, 1] 区间,真正出现负值的情况极少。
- 欧氏距离(Euclidean Distance)
衡量的是两个点在空间中的直线距离,受向量长度影响大。两个意思相同但长度不同的向量,欧氏距离可能很大但余弦相似度很高。通常不优先选用。
- 点积(Dot Product)
当向量已经做了 L2 归一化(长度为 1)时,点积就等于余弦相似度。如果向量已归一化,用点积效率更高。
举例说明
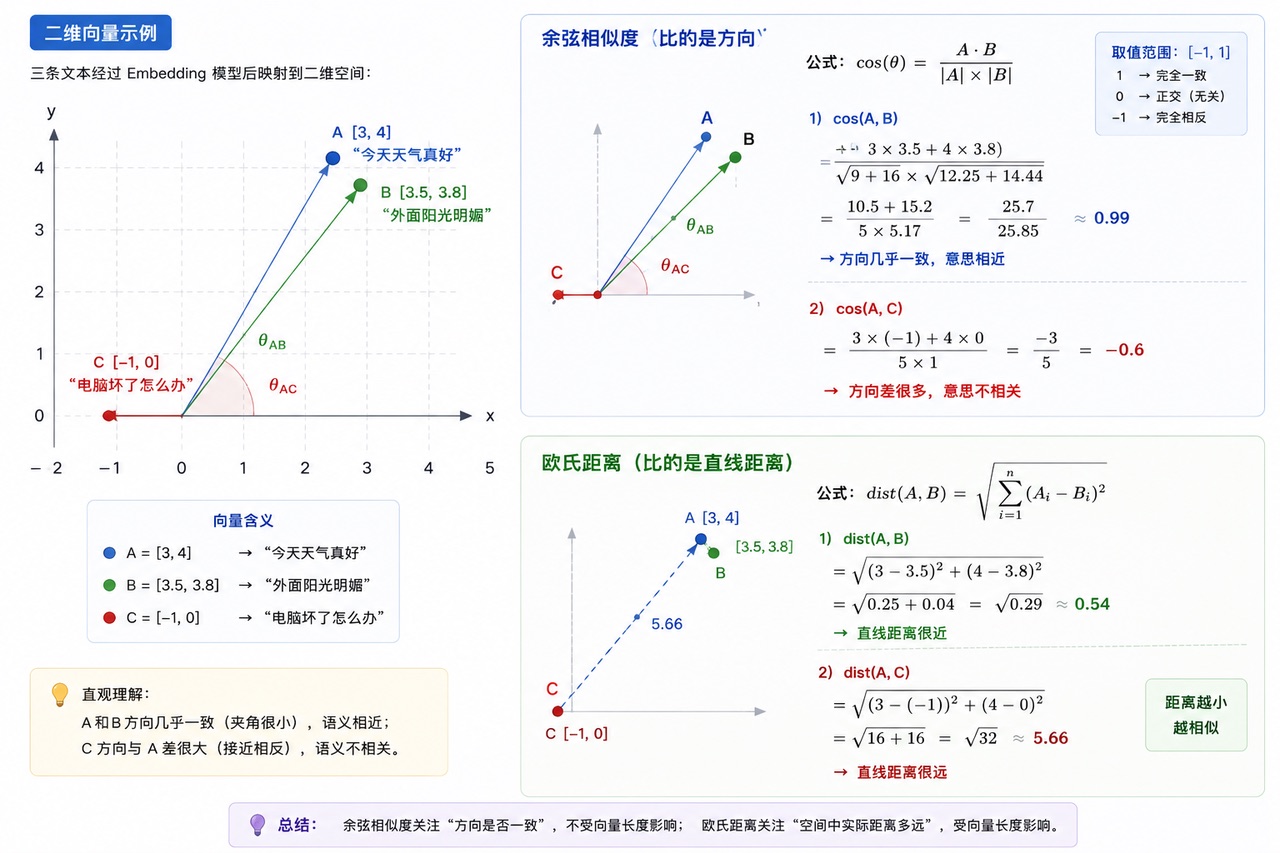
二维向量手算一遍就清楚了。假设我们有两条文本的向量(降维到 2D 方便看):
1 | |
余弦相似度: 比的是方向。
1 | |
欧氏距离: 比的是直线距离。
1 | |
两种度量都能区分 “相近” 和 “不相关”,但关注点不同 —— 余弦看方向,欧氏看绝对距离,能力各异,用途不同。
向量索引
有了度量方法,就可以逐条算查询向量和所有存储向量的相似度,排序取 Top-K。这个问题的学名叫 KNN(K-Nearest Neighbors,K 最近邻)。解法分两条路:
- 精确 KNN: 逐条遍历所有向量,逐一算相似度,排序取 Top-K。100% 精确,但复杂度是 O (N×D)——N 条向量、每条 D 维。万级数据还行,百万级开始就扛不住了,更别提千万级。
- 近似 KNN(ANN): 不逐条算,用索引结构快速锁定候选区域,只对少数候选向量做精确计算。牺牲一点召回精度,换数量级的性能提升。主流实现有 HNSW、IVF、PQ、LSH 等。
HNSW 原理
💡 核心灵感:跳表 * 可导航小世界图
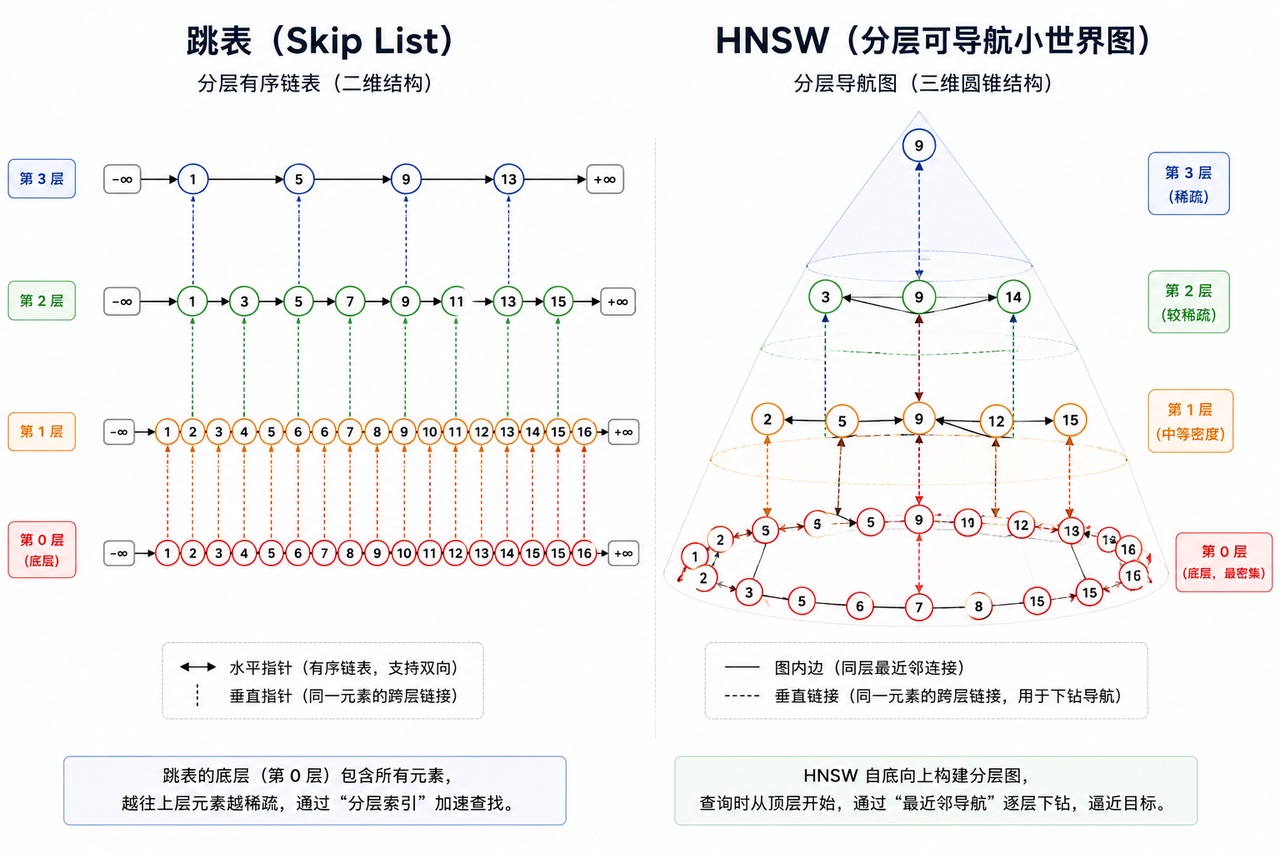
HNSW 是两种经典数据结构的融合。
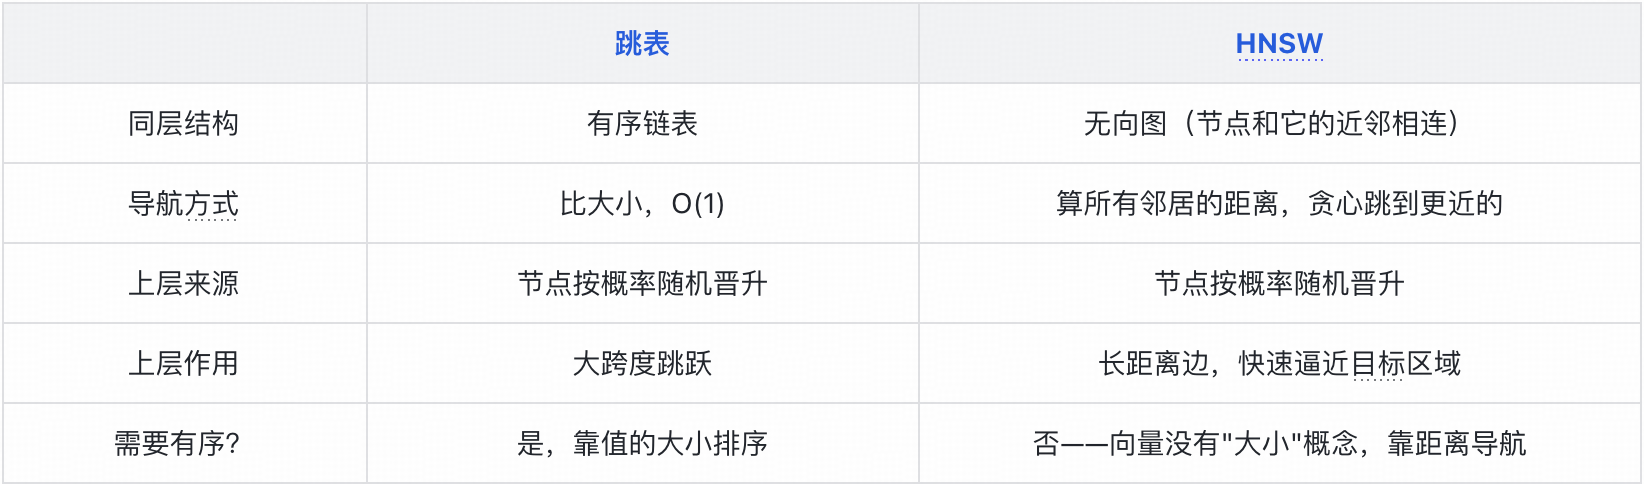
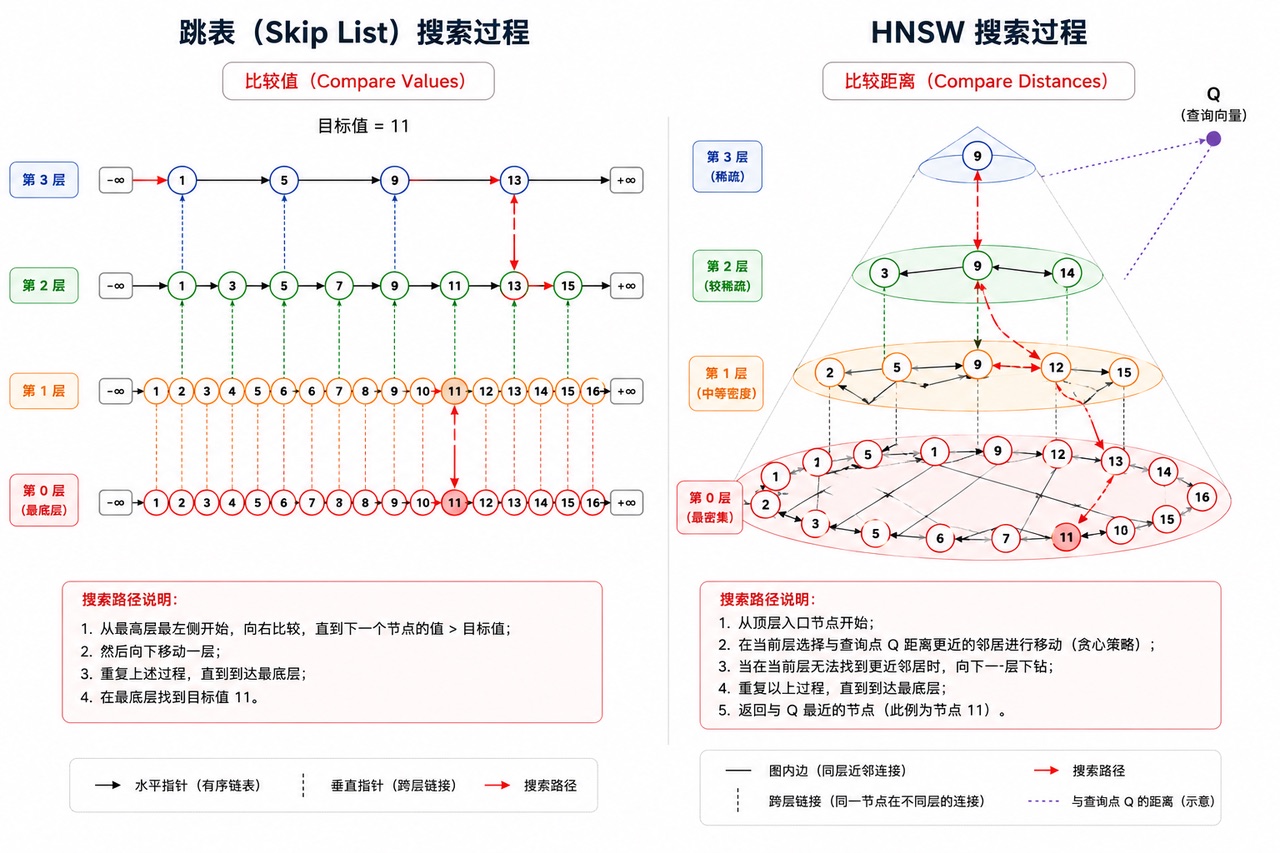
第一个灵感来自跳表 —— 在有序链表上增加多层 “快速通道”:
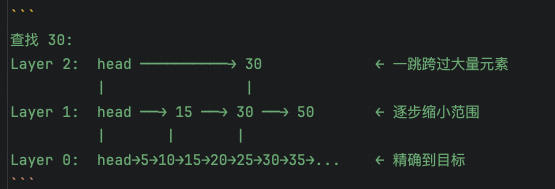
上层节点少、跨度大,底层包含全部节点。查找时从顶层一跳跨过大量元素,逐层缩小范围,复杂度从 O (n) 降到 O (log n)。
节点按概率随机晋升到上层,不需要全局重平衡 —— 随机性自动保证了层间分布符合预期的指数衰减规律。
HNSW 把这个分层思想搬到了图上。但这里有个关键问题:跳表能工作,是因为链表是有序的,比一下大小就知道往左还是往右。向量没有 “大小” 概念 —— 向量 (1, 3) 和 (-2, 5) 谁大?没法比。光有分层不够,还得解决 “图上怎么导航”。
HNSW 的层间连接机制和跳表完全一致 —— 每个节点按概率随机分配到若干层,同时存在于所属层及以下所有层。层与层之间没有跨节点的连线,只有同一节点在相邻层的纵向连接。上层粗定位找到近似最近邻后,顺着该节点的纵向连线降到下一层,逐层下沉到第 0 层精搜。
第二个灵感来自可导航小世界图(NSW): 每一层图中,只要每个节点连了它最近的几个邻居,贪心搜索就能快速导航到目标附近 —— 不需要全局有序,只需要局部比较。站在当前节点,看一圈邻居,跳到离目标更近的那个,如此循环。
两个想法一组合,分层提供 “快速通道”,贪心搜索在每层图上导航 —— 这就是 HNSW 的全部核心。用表格对比看得更清楚:
跳表 vs HNSW 的关键区别
搜索过程对比
为什么用 HNSW 而不是暴力 KNN
精确 KNN 需要把查询向量与库里每一个向量都算一遍距离,数据量到百万级时延迟无法接受。业界事实标准是 HNSW(分层可导航小世界图)——一种近似 最近邻(ANN)算法,用极小的精度损失换取数量级的速度提升。
- 分层图结构:借鉴跳表思想,构建多层邻近图。上层稀疏(大跨度快速逼近),下层稠密(精细定位)。
- 贪婪路由搜索:从最高层入口点出发,使用贪心算法每步跳到离查询更近的邻居,逐层下沉,直到在底层找到最近邻。
- 关键参数:
m(每个节点的连接数)、ef_construction(建图时候选集大小)越大则召回率越高、但索引更大更慢,需按场景权衡。
✅ 优点: 理解语义关联,容错错别字/模糊描述,支持跨语言与多模态。短板: 对专有名词、缩写(RAG、RLHF)、ID(gpt-3.5-turbo)等”字面精确”需求反而容易失准——这正是需要和全文检索组成混合检索的原因。
向量索引参数举例
详见:元信息知识库
m:每层每个向量节点的最大邻居连接数(邻居连接数)- m 越大:连接越多,检索更准,但索引占用磁盘更大、建库更慢;
ef_construction:(写路径)建索引时,找邻居的候选数量- 建图时搜更多邻近节点,公路连得更合理,索引质量更高;
ef_search:(读路径)查询时每层搜索的候选数量- ef 越大,召回精度越高,但查询速度变慢;调参就是平衡「速度 / 准确率」。
1 | |
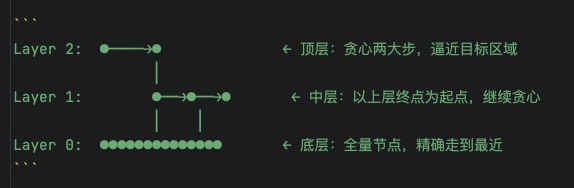
搜索流程
- 从最顶层的入口节点开始,做贪心搜索,走到这一层的局部最近点。
- 降到下一层,以上一层的终点为起点,继续贪心。
- 重复直到最底层 —— 底层包含全部节点、边最密集,做完最后一轮精细搜索。
- 返回途中遇到的、距离最近的 K 个节点。
全文检索
全文检索又称词法检索 / 关键词检索,把文本表示为”稀疏向量”(只有出现过的词才有权重)。它的核心是倒排索引 + BM25 相关性打分,擅长专有名词、编号、精确短语的匹配,是 Google、百度、Elasticsearch 等搜索引擎的基石。
核心原理:倒排索引
普通”正排索引”是”文档 → 包含哪些词”,模糊查询只能逐行扫描,速度极慢。倒排索引反过来建立”词 → 出现在哪些文档”的映射,查询时直接命中包含该词的文档集合,实现毫秒级检索。
flowchart LR
  D["文档集合
Doc1: 向量检索原理
Doc2: 全文检索原理
Doc3: 混合检索方案"] --> A["分词 + 归一化
(去停用词/大小写)"]
  A --> I["倒排索引 词->文档"]
  I --> T1[检索: Doc2, Doc3]
  I --> T2[原理: Doc1, Doc2]
  I --> T3[向量: Doc1]
  I --> T4[混合: Doc3]
检索流程
- 建索引(离线):对文档分词(中文需 IK/jieba 等分词器)、去停用词、词条归一化(大小写、同义词),再记录每个词的文档 ID、词频(TF)、文档长度等信息,写入倒排索引。
- 解析 Query:对用户查询做同样的分词,得到查询词集合 Terms。
- 召回:在倒排索引中查出包含这些 Term 的候选文档。
- BM25 打分排序:对每个候选文档计算 BM25 相关性得分,从高到低返回。
分词
分词(Tokenization / Analysis)是全文检索的第一步、也是最关键的一步——把一整段文本切分成一个个最小检索单元”词项(Term)”。倒排索引存的是词项,用户查询也要切成词项,两边用同一套分词规则才能对得上。中文没有空格天然分隔,因此分词质量直接决定召回效果[ElasticSearch-分词器的用法]。
ES 分词器(Analyzer)的三段式流水线
在 Elasticsearch 中,分词由 Analyzer 完成,它固定由三部分按顺序组成:字符过滤器 → 分词器 → 词元过滤器,其中 Tokenizer 有且仅有一个[Elasticsearch tokenizer、analyzer、filter]。
flowchart LR
  RAW["原始文本
The Quick Brown-Foxes 跑了"] --> CF["Character Filter
字符过滤: 去HTML/全半角转换"]
  CF --> TK["Tokenizer
切词: 唯一, 决定切分规则"]
  TK --> TF["Token Filter
词元过滤: 转小写/去停用词/同义词/词干还原"]
  TF --> TERMS["词项 Terms
quick / brown / fox / 跑"]- Character Filter(字符过滤器,0~N 个):在切词前处理原始字符流,如去除 HTML 标签、全角转半角、繁简转换。
- Tokenizer(分词器,有且仅有 1 个):核心切分逻辑。英文可按空格/标点切;中文必须用专门的中文分词器。
- Token Filter(词元过滤器,0~N 个):对切出的词做加工——转小写、去停用词(的/了/is/the)、同义词扩展、英文词干还原(running→run)。
中文分词:以 IK 分词器为例
ES 内置的 standard 分词器会把每个汉字单独切开(”我爱技术”→我/爱/技/术),完全不可用,因此中文场景普遍安装 IK 分词器——一款基于词典 + 规则的中文分词器,提供两种粒度模式[IK分词器详解]。
| 模式 | 粒度 | “中华人民共和国国歌” 切分结果 | 适用场景 |
|---|---|---|---|
ik_max_word |
最细粒度 | 中华人民共和国 / 中华人民 / 中华 / 华人 / 人民共和国 / 人民 / 共和国 / 国歌…(穷尽所有组合) | 建索引:尽可能多切,提升召回 |
ik_smart |
最粗粒度 | 中华人民共和国 / 国歌 | 查询:切得精简,提升精度 |
💡 常见实践: 建索引用
ik_max_word(细粒度、多切词、保召回),查询用ik_smart(粗粒度、少切词、提精度);在 Mapping 中通过analyzer+search_analyzer分别指定。IK 还支持通过自定义词典扩展新词(如公司专有名词)和停用词,这是中文全文检索相较向量检索”可控性强”的重要优势[使用IK分词插件及更新IK词典]。
ES 常用内置分词器(Built-in Analyzers)
除了中文专用的 IK,Elasticsearch 还自带一批开箱即用的分词器,覆盖英文、多语言、精确匹配、前缀匹配等场景。可用 GET /_analyze API 直接验证任意分词器的切分效果[ElasticSearch分词器详解]。
| 分词器 | 切分规则 | 示例:”The Quick Foxes, run!” | 适用场景 |
|---|---|---|---|
standard(默认) |
按 Unicode 文本分段,去标点、转小写 | the / quick / foxes / run | 大多数西文;中文会被切成单字,不适用 |
simple |
遇非字母即切,去数字/标点,转小写 | the / quick / foxes / run | 只保留纯字母词 |
whitespace |
仅按空白切,不去标点、不转小写 | The / Quick / Foxes, / run! | 需保留大小写/符号的日志等 |
stop |
simple 基础上增加停用词过滤(the/a/is) | quick / foxes / run | 过滤无意义高频词 |
keyword |
完全不分词,整段作为一个词项 | The Quick Foxes, run! | 精确匹配:ID、状态、标签 |
pattern |
按正则切分(默认 \W+),支持停用词、转小写 |
the / quick / foxes / run | 自定义分隔规则 |
language(如 english) |
特定语言分词,含词干还原+停用词 | quick / fox / run(foxes→fox) | 英文等单一语种,提升召回 |
此外还有两类常用于特定匹配需求的分词器 / Tokenizer:
ngram/edge_ngram:把词按 N 个字符滑窗切分(如 “fox”→ fo/ox 或 f/fo/fox),用于部分匹配、前缀搜索、search-as-you-type(输入即搜);也可弥补 IK 对”英文型号 + 中文”混合词切不开的问题[使用IK分词插件]。pinyin(第三方插件):把中文转拼音,支持”quanwen”→”全文”这类拼音搜索,常与 IK 组合成自定义 analyzer 使用。
💡 选型要点: 英文语义检索优先
english(有词干还原);需保留原样用whitespace;精确匹配用keyword;前缀/输入联想用edge_ngram;中文用 IK(可叠加 pinyin)。一个字段还可用fields建多个子字段、各挂不同分词器(如正文用 IK、content.keyword做精确匹配),兼顾多种查询需求。
倒排索引
倒排索引(Inverted Index)是全文检索能做到毫秒级响应的根本原因。与其逐篇文档扫描”这篇文章里有没有这个词”(正排),不如反过来预先建好”每个词分别出现在哪些文档“(倒排),查询时直接拿词去命中文档列表。
三层核心数据结构
在 Lucene / Elasticsearch 中,倒排索引由三部分组成:Term Index → Term Dictionary → Posting List,逐层定位[Elasticsearch 倒排索引的实现]。
flowchart TD
  Q["查询词: 检索"] --> TI["Term Index 词项索引
(FST, 常驻内存)
快速定位词在字典中的块地址"]
  TI --> TD["Term Dictionary 词项字典
(排序词表)
存词项 + 文档频率DF + 指向倒排表的指针"]
  TD --> PL["Posting List 倒排表
[DocID, 词频TF, 位置Position, 偏移Offset]"]
PL --> DOC["定位到文档: Doc2, Doc3 ..."]- Term Index(词项索引):用 FST(有限状态转换机) 实现,体积小、可常驻内存。作用是快速判断某个词是否存在,并定位它在 Term Dictionary 中的大致块地址,避免全字典扫描。
- Term Dictionary(词项字典):按字典序排好的全部词项,记录每个词的文档频率(DF) 等统计信息,以及指向 Posting List 的指针。可用二分查找快速定位。
- Posting List(倒排表):每个词对应的文档列表,记录 文档ID、词频(TF)、位置(Position)、偏移(Offset)。TF/DF 供 BM25 打分,Position 供短语查询(match_phrase)判断词序。
构建流程(离线,写入时)
- 分词:文档正文经 Analyzer 切成词项流。
- 统计:记录每个词项在各文档中的 TF、Position,以及文档长度。
- 归并排序:把 “词项 → 文档” 的映射按词项排序,写入 Term Dictionary 与 Posting List。
- 构建 Term Index:为词项字典建 FST 索引,加速后续查找。
举例:3 篇文档如何建成倒排索引
下面用一个最小语料(3 篇短文档)走一遍上面流程图的四步,看倒排索引到底是怎么”攒”出来的。假设原始语料如下:
| 文档 ID | 正文内容 |
|---|---|
Doc1 |
全文检索 原理 |
Doc2 |
向量检索 原理 |
Doc3 |
全文检索 与 向量检索 |
第 1 步 · 分词:每篇文档正文经 Analyzer 切成词项流(这里按词切、去掉停用词”与”)。
- Doc1 →
全文检索/原理 - Doc2 →
向量检索/原理 - Doc3 →
全文检索/向量检索
第 2 步 · 统计:记录每个词项在各文档中的词频 TF、出现位置 Position,以及文档长度(词数)。
| 文档 | 词项 | TF(词频) | Position |
|---|---|---|---|
Doc1(长度 2) |
全文检索 | 1 | 0 |
Doc1 |
原理 | 1 | 1 |
Doc2(长度 2) |
向量检索 | 1 | 0 |
Doc2 |
原理 | 1 | 1 |
Doc3(长度 2) |
全文检索 | 1 | 0 |
Doc3 |
向量检索 | 1 | 1 |
第 3 步 · 归并排序:把上一步”文档 → 词项”的映射翻转并按词项字典序排序,同一词项的文档合并进一条 Posting List,同时在 Term Dictionary 里记下它的文档频率 DF。这一步得到的就是倒排索引的主体:
| 词项(Term Dictionary,按字典序) | DF | Posting List [DocID:TF@Position] |
|---|---|---|
全文检索 |
2 | Doc1:1@0 → Doc3:1@0 |
原理 |
2 | Doc1:1@1 → Doc2:1@1 |
向量检索 |
2 | Doc2:1@0 → Doc3:1@1 |
第 4 步 · 构建 Term Index:为上面排好序的词项字典建 FST 索引(常驻内存),这样查询词进来时不用扫全表,直接定位到它在字典中的块地址。最终三层结构串起来:
flowchart TD
  Q["查询词: 全文检索"] --> TI["Term Index (FST)
定位词项块地址"]
  TI --> TD["Term Dictionary
全文检索 DF=2 指针"]
  TD --> PL["Posting List
Doc1@0 Doc3@0"]
  PL --> R["命中文档: Doc1, Doc3"]
🔍 回看这条索引怎么用: 用户查”全文检索”时,Term Index 秒定位到该词,取出 Posting List
[Doc1, Doc3]即为候选;若同时查”全文检索 AND 向量检索”,则对两条 Posting List([Doc1,Doc3]与[Doc2,Doc3])求交集得[Doc3]——这正是前面「工程优化」里跳表 / Roaring Bitmap 要加速的操作。
💡 工程优化: Posting List 中的 DocID 用差值存储 + 整型压缩(如 PackedBlock/VInt)大幅节省空间;多个词的 Posting List 求交集时用跳表(Skip List) 或 Roaring Bitmap 加速,这是布尔查询 “A AND B” 高效的关键[倒排索引的数据结构]。
Query 匹配
Query 匹配是全文检索的在线阶段:用户输入一句话,系统把它转成词项、去倒排索引里找候选文档、再用 BM25 打分排序返回。关键点在于——查询串必须经过和建索引时一致(或兼容)的分词,否则词项对不上就召回为空[Match query 官方文档]。
match 查询的完整流程
flowchart TD
  Q["用户 Query: 全文检索原理"] --> A["1. Query 分词
(search_analyzer)
-> [全文检索, 原理]"]
  A --> B["2. 倒排索引查词
Term Index -> Dictionary -> Posting List"]
  B --> C["3. 布尔合并候选集
默认 OR: 命中任一词即入选
可选 AND / minimum_should_match"]
  C --> D["4. BM25 打分
逐个候选文档算相关性得分"]
D --> E["5. 按分数降序返回 Top-N"]- 查询分词:match 查询会先用
search_analyzer对查询串分词,得到查询词项集合 Terms(如 “全文检索原理” → 全文检索 / 原理)。 - 倒排查词:对每个 Term 走 Term Index → Term Dictionary → Posting List,取出各自的候选文档列表。
- 布尔合并:默认
operator=OR——命中任意一个词的文档都进入候选;设AND则需全部命中;minimum_should_match可控制”至少命中几个词”。 - BM25 打分:对候选集里每篇文档,按查询词的 TF、IDF、文档长度算出 BM25 相关性得分。
- 排序返回:按得分从高到低返回 Top-N。
match vs match_phrase vs term
| 查询类型 | 是否分词 | 匹配逻辑 | 典型用途 |
|---|---|---|---|
match |
是 | 分词后按 OR/AND 匹配任意/全部词项 | 常规全文检索 |
match_phrase |
是 | 词项须连续且顺序一致(用 Position 判断) | 精确短语,如”全文检索”不拆 |
term |
否 | 不分词,整体精确匹配 | keyword 字段:ID、状态、标签 |
举例:同一份数据,三种查询差在哪
假设 content 是 text 字段(按词分词),索引里有 3 篇文档,分词后的词项与位置如下:
| 文档 | 原文 | 分词结果 [词项@位置] |
|---|---|---|
Doc1 |
全文 检索 很 强大 | 全文@0 / 检索@1 / 很@2 / 强大@3 |
Doc2 |
检索 全文 数据 | 检索@0 / 全文@1 / 数据@2 |
Doc3 |
全文 数据 检索 | 全文@0 / 数据@1 / 检索@2 |
现在用同一个查询串「全文 检索」 分别发起三种查询,命中结果完全不同:
| 查询 | 内部逻辑 | 命中 | 为什么 |
|---|---|---|---|
match: 全文 检索 |
分词成 [全文, 检索],默认 OR:命中任一词即入选 | Doc1 / Doc2 / Doc3 | 三篇都同时含”全文”和”检索”,全部召回 |
match_phrase: 全文 检索 |
分词成 [全文, 检索],要求两词相邻且顺序为 全文→检索(靠 Position 判断) | 仅 Doc1 | Doc1 全文@0、检索@1 相邻且顺序对;Doc2 顺序反了;Doc3 中间隔了”数据” |
term: 全文 检索 |
完全不分词,把整串 “全文 检索” 当作一个词项去精确匹配 | 无 | text 字段里只有”全文””检索”等单词词项,不存在”全文 检索”这个整体词项 |
🎯 一句话记忆:
match管”有没有这些词”(召回广)、match_phrase管”这些词是不是连在一起按顺序出现”(短语精确)、term管”字段值是不是一模一样”(整体精确,只适合keyword字段)。上例中若把term换到content.keyword子字段查 “全文 检索 很 强大”,才能精确命中 Doc1。
💡 常见坑: 对
text字段用term精确匹配常常查不到——因为 text 字段建索引时已被分词成小写词项,而 term 不分词、按原样匹配,大小写或整句都对不上。精确匹配请用keyword子字段(如 Mapping 中的content.keyword);全文匹配请用match。此外查询若被停用词过滤器清空(如查询全是”的了呢”),默认zero_terms_query=none会返回空结果。
BM25 打分:词频 × 逆文档频率
BM25(Best Match 25)用一句话概括:相关性得分 = 每个查询词的重要性(IDF) × 该词在文档中的出现情况(TF,经词频饱和与长度归一化调整)。
- TF 词频:词在文档里出现越多越相关,但引入饱和机制——出现第 10 次和第 100 次的增益趋于平缓,避免堆砌关键词刷分。
- IDF 逆文档频率:越稀有的词区分度越高、权重越大;”的、是”这类到处都有的词权重极低。
- 文档长度归一化:长文档天然更容易命中词,故对长度做惩罚,避免长文永远占优。
✅ 优点: 速度快、可解释、对专有名词/编号/精确短语极准,中文场景下自定义词典与同义词扩展可控。短板: 依赖字面匹配,遇到同义词(”手机” vs “移动电话”)、错别字、口语化表达时容易漏召回。
RRF 倒排融合
由于全文检索和向量检索得出的分数无法归一化,向量检索 -1 ~ 1,全文检索 0 ~ 几十,所以需要使用 **RRF(Reciprocal Rank Fusion,倒数排名融合)根据排名计算出文档的最终排名,**RRF 的思路很朴素 —— 既然原始分数没法直接加,那就扔掉分数,只看排名。
计算公式:
1 | |
- k = 60:平滑常数,值越大曲线越平缓,排名靠前的权重差距越小。
- rank_i:文档在第 i 路检索中的排名,从 1 开始。
- 某路未出现的文档,该路贡献为 0(相当于排名无限大,1/(k+∞) → 0)。
Rerank 精排
Recall(ANN + BM25 + RRF)做的事是粗筛 —— 从海量文档里快速捞出几十条候选。但捞出来的这几十条只是 “可能相关”,谁排在谁前面还不够准。Rerank 做的事是精排 —— 用一个更强的模型,对这几十条候选重新打分排序,把真正最相关的推到最前面。
- 解决什么痛点?
RRF 只是粗暴按排名合并,存在明显缺陷: 有些文档关键词命中多但语义无关(关键词噪音);有些语义接近但匹配度弱; RRF 分不清细微相关性差异,需要更强模型逐篇精细打分。
- Rerank 到底在做什么
输入是RRF 过滤后的少量文档(10~30 条,数量必须少),拿一个更强的深度模型(如 bge-reranker-m2-v3),逐条对比「用户 query + 单条文档全文」,输出 0~1 的精确相关分,再按这个新分数重新排序。
常见两种精排模型:
- Cross-Bert 交叉编码器:同时输入 query + 文档,深度交互理解语义,精度最高;
- ES 内置 rerank、LLM 打分:轻量大模型判断相关性。
举例: RRF 合并后候选列表:[docA, docB, docC, docD] 用户问题:项目用什么数据库
- docA:大量关键词 “数据库”,但内容讲云数据库运维,和项目选型无关;
- docB:关键词少,但完整回答公司使用 Postgres,高度贴合用户问题。
RRF 会把 docA 放前面,但 Cross-Bert 精排后,能识别 docB 语义更匹配,直接交换两者排名。
Rerank 的特点
- 依赖深度学习模型,算力开销大、速度慢,绝对不能给百级文档跑;
- 深度理解文本语义,能区分弱相关 / 强相关、过滤关键词噪音;
- 只能处理少量候选,必须放在 RRF 之后,先靠 RRF 缩减候选池;
- 作用是微调最终名次,是检索链路的 “最后一步精细打磨”。
示例(以 ES + ES KNN 举例)
存储结构
1 | |
上面的 Mapping 一次性定义了三类字段:
- 过滤字段(user_id 等,用于隔离用户数据)
- BM25 全文字段(content / entity,走倒排索引)
- KNN 向量字段(content_embedding,走 HNSW 向量索引)
下面按”写入 → 双路检索 → RRF 融合”完整走一遍。
步骤 1:写入文档(同时落两类索引)
写入时同一条记录里,content 交给分词器建倒排索引,content_embedding(由 Embedding 模型离线算好的 768 维向量)交给 HNSW 建向量索引。
1 | |
步骤 2:全文检索路(BM25)
用 match 查询命中倒排索引,同时用 filter 前置隔离当前用户,ES 内部用 BM25 打分排序。
1 | |
步骤 3:向量检索路(ES KNN)
先把 Query 用同一个 Embedding 模型转成向量,再用 knn 在 HNSW 索引里找最近邻,filter 同样做用户隔离。
1 | |
💡
k是最终返回的近邻数;num_candidates是 HNSW 搜索时每个分片考察的候选数,越大召回越准但越慢,通常设为 k 的 5~10 倍。
步骤 4:一次请求完成混合检索 + RRF 融合
Elasticsearch 8.x 起支持在单个请求 里同时写 query(全文)与 knn(向量),并用 rank.rrf 把两路结果按排名融合成一个统一列表——无需在应用层手动合并分数。
1 | |
整体链路图
flowchart TD
  Q[用户 Query: 模型答非所问] --> EMB["Embedding 模型
生成 query_vector"]
  Q --> BM["match 全文检索
倒排索引 + BM25"]
  EMB --> KNN["knn 向量检索
HNSW + cosine"]
  BM --> RA["结果列表 A
content 关键词命中"]
  KNN --> RB["结果列表 B
语义相似命中"]
  RA --> RRF["rank.rrf 融合
score = Σ 1/(60 + rank)"]
  RB --> RRF
  RRF --> OUT["统一排序 Top-K
喂给 LLM 生成答案"]
这样,”模型答非所问” 既能通过 BM25 精确命中包含相同关键词的记忆,又能通过 KNN 召回语义相近但用词不同的 “输出与问题无关 / 幻觉严重” 等记忆,最终由 RRF 融合出兼顾精确与语义的结果列表,显著提升 RAG 的召回率与答案质量。