业界 Memory 解决方案
MemGPT(Letta)
核心理念
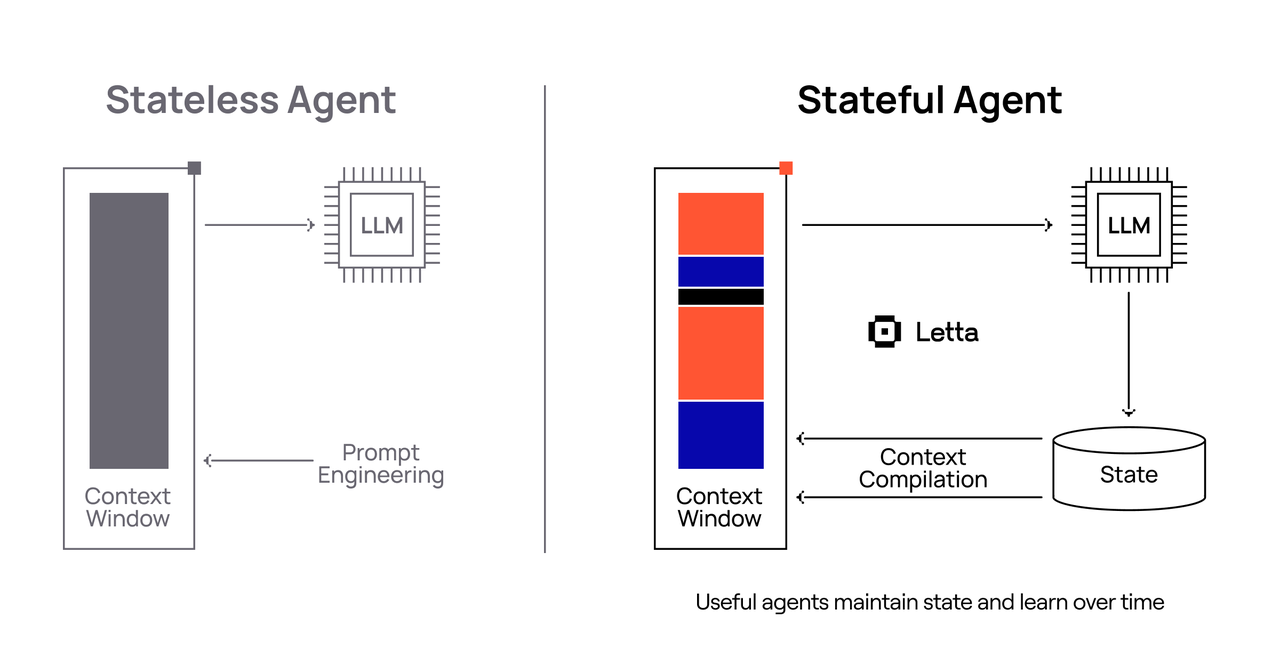
将 LLM 的固定上下文窗口类比为计算机的“物理内存(RAM)”,而将外部的向量数据库等存储类比为“磁盘”。MemGPT 扮演的角色则是一个“内存管理器”,负责在两者之间高效、智能地换入换出(Page In / Page Out)信息。
flowchart LR
    %% --- 样式定义 ---
    classDef user fill:#bbdefb,stroke:#1976d2,stroke-width:2px,color:#0d47a1;
    classDef middleware fill:#e1bee7,stroke:#7b1fa2,stroke-width:4px,color:#4a148c;
    classDef llm fill:#c8e6c9,stroke:#388e3c,stroke-width:2px,stroke-dasharray: 5 5,color:#1b5e20;
    classDef db fill:#ffe0b2,stroke:#f57c00,stroke-width:2px,color:#e65100;

    %% --- 节点定义 (重点:所有标签都加了双引号,防止报错) ---

    User(("用户 (Client)")):::user

    %% 中间层区域
    subgraph MemGPT ["MemGPT 中间层 (Stateful Middleware)"]
        direction TB
        Agent["智能体核心 (Agent)"]:::middleware
        Memory[("长期记忆 (Database)")]:::db
    end

    %% 后端大模型
    LLM["LLM API <br/> (GPT-4 / Llama 3)"]:::llm

    %% --- 连线逻辑 ---

    %% 1. 用户只跟中间层交互
    User <==>|"① 对话流"| Agent

    %% 2. 中间层内部读写记忆
    Agent <==>|"② 存取记忆"| Memory

    %% 3. 中间层调用无状态 LLM
    Agent <==>|"③ 推理请求"| LLM
整体流程
---
title: MemGPT 核心机制
---
graph LR

U[用户输入] --> H

subgraph A[主上下文(物理内存)]
    R[只读区<br/>核心人格/用户画像]
    W[工作区<br/>思考链/工具输出]
    H[对话区<br/>最近历史]
    R --> W --> H
end

subgraph B[外部存储(磁盘)]
    V[向量数据库<br/>情景记忆/语义记忆]
end

subgraph C[换入换出与自省]
    T[触发条件<br/>容量阈值/新任务/关键信息]
    O[换出指令<br/>总结不重要内容]
    S[摘要写入]
    I[自省评估<br/>是否需要回忆]
    F[函数调用<br/>search_memory]
    Q[语义检索]
    L[换入加载<br/>相关记忆片段]
    T --> O --> S
    I --> F --> Q --> L
end

subgraph D[推理与输出]
    M[模型推理]
    O2[响应输出]
    M --> O2
end

H --> I
S --> V
V --> Q
L --> H
H --> M
GraphRAG
💡 延伸阅读:GraphRAG
核心理念
GraphRAG 通过在 RAG 流程之前引入知识图谱构建步骤,有效解决了传统 RAG 的两大痛点:
- 克服语义鸿沟:传统 RAG 依赖向量相似度,常常检索到语义相似但逻辑无关的“噪声”信息。GraphRAG 将非结构化文本转化为结构化的实体和关系网络,检索时不再是寻找模糊的“相似文本”,而是在这个网络中寻找逻辑上强相关的“知识路径”。这使得检索结果与查询意图的关联性更强,显著提升了上下文的质量。
- 支持多跳推理与复杂问题分解:对于需要综合多个信息点才能回答的复杂问题(如“A 公司的产品 B 与 C 公司的产品 D 有哪些竞争关系?”),传统 RAG 往往力不从心。GraphRAG 则可以将这类问题分解为图上的查询路径,通过遍历实体间的关系来发现隐藏的、深度的关联,为多跳推理提供了坚实的基础。
---
title: GraphRAG 数据模型
---
flowchart TB
  %% GraphRAG 数据模型

  subgraph G["图谱层(Graph)"]
    direction TB
    subgraph N["实体(Nodes)"]
      direction TB
      E1["实体:人物/组织/产品/地点/概念"]
      E2["示例:A公司、B公司、产品A、技术B"]
    end

    subgraph R["关系(Edges,有向)"]
      direction TB
      R1["关系:描述实体联系"]
      R2["示例:A公司 -[收购]-> B公司"]
      R3["示例:产品A -[基于]-> 技术B"]
    end

    E1 --> R1
    R1 --> E1
  end

  subgraph C["社区层"]
    direction TB
    C1["社区/主题节点:把紧密连接的实体聚成主题"]
    C2["示例主题:AI 训练"]
    C1 --> C2
    C1 -.聚合.-> E1
  end

  subgraph M["元数据"]
    direction TB
    M1["属性:描述/背景等(可挂在实体或关系上)"]
    M2["置信度:抽取可信度评分"]
  end

  M1 -.附加.-> E1
  M1 -.附加.-> R1
  M2 -.附加.-> E1
M2 -.附加.-> R1- 实体 (Entities):从文本中抽取的关键名词,如人物、组织、产品、地点、概念等。每个实体都是图中的一个节点。
- 关系 (Relationships):连接实体的有向边,描述实体之间的具体联系,如
(A公司) -[收购]-> (B公司),(产品A) -[基于]-> (技术B)。 - 社区/主题节点 (Communities / Topics):通过社区检测算法(如 Leiden 或 Louvain)将图中紧密连接的实体聚类,形成更高层次的“主题”或“社区”节点。例如,多个关于“机器学习模型”和“训练数据”的实体可能被归入一个名为“AI 训练”的社区。这为宏观、概要性的查询提供了入口。
- 属性与置信度 (Attributes & Confidence):实体和关系都可以拥有详细的属性,如实体的描述、关系发生的背景等。同时,每个由 LLM 抽取出的元素都附带一个置信度分数,用于评估其可靠性。
整体流程
---
title: GraphRAG 数据写入与检索机制
---
flowchart LR
  classDef step fill:#ffffff,stroke:#2F3C4F,stroke-width:1px,color:#15202B,rx:8,ry:8;
  classDef data fill:#F6FAFF,stroke:#2B6CB0,stroke-width:1px,color:#102A43,rx:8,ry:8;
  classDef store fill:#F0FFF4,stroke:#2F855A,stroke-width:1px,color:#0B2F1F,rx:8,ry:8;
  classDef llm fill:#FFF5F5,stroke:#C53030,stroke-width:1px,color:#3B0A0A,rx:8,ry:8;
  classDef algo fill:#FFFBEB,stroke:#B7791F,stroke-width:1px,color:#3A2B10,rx:8,ry:8;
  classDef out fill:#FAF5FF,stroke:#6B46C1,stroke-width:1px,color:#1A1033,rx:8,ry:8;
  classDef note fill:#F7FAFC,stroke:#A0AEC0,stroke-dasharray: 4 3,color:#2D3748,rx:8,ry:8;

  U[用户问题]:::data
  A[最终答案]:::out

  subgraph W[GraphRAG 数据写入机制]
    direction LR
    W1[源文档<br/>PDF HTML MD 网页 内部知识库]:::data
    W2[文档预处理<br/>清洗 去噪 分段 Chunking 元数据]:::step
    W3[LLM 知识抽取<br/>实体 关系 事件 属性 JSON]:::llm
    W4[实体消歧与合并<br/>规范化 同义归一 ID 对齐]:::algo
    W5[写入图存储<br/>实体节点 关系边 描述文本]:::store
    W6[社区检测与层级化<br/>主题簇 Community 节点<br/>LLM 生成社区摘要]:::algo
    W7[索引构建<br/>混合检索]:::step
    W7a[向量索引<br/>实体 关系描述 社区摘要 Embedding]:::store
    W7b[关键词索引<br/>BM25 倒排 可选]:::store
    W7c[结构索引<br/>图邻接 度量 路径信息]:::store
    W8[产物 可检索知识基<br/>图 多索引 摘要]:::out

    W1 --> W2 --> W3 --> W4 --> W5 --> W6 --> W7
    W7 --> W7a
    W7 --> W7b
    W7 --> W7c
    W7 --> W8

    N1[并行化要点<br/>按文档或 Chunk 并行抽取<br/>合并阶段做全局对齐]:::note
    W3 -.-> N1
    W4 -.-> N1
  end

  subgraph R[GraphRAG 数据检索机制]
    direction LR
    R1[问题理解<br/>意图识别 关键实体 约束抽取]:::step
    R2[向量化问题<br/>Query Embedding]:::step
    R3[种子社区选取<br/>社区摘要索引召回 TopK]:::algo
    R4[k hop 扩展 邻域探索<br/>社区 实体 关系<br/>形成相关子图]:::algo
    R5[多源召回融合 可选<br/>向量 关键词 图结构信号]:::step
    R6[聚合与上下文构建<br/>实体 关系 证据片段<br/>去重与排序]:::step
    R7[LLM 子图摘要<br/>整合图信息与证据]:::llm
    R8[重排与最终生成<br/>Rerank 可选 Answer LLM]:::llm
    R9[输出<br/>答案与可追溯证据]:::out

    U --> R1 --> R2 --> R3 --> R4 --> R5 --> R6 --> R7 --> R8 --> R9 --> A
  end

  W5 -. 图结构 .-> R4
  W6 -. 社区摘要 .-> R3
  W7a -. 向量索引 .-> R3
  W7a -. 向量索引 .-> R5
  W7b -. 关键词索引 .-> R5
  W7c -. 结构索引 .-> R4

  linkStyle default stroke:#94A3B8,stroke-width:1px
数据写入机制
GraphRAG 的数据写入是一个由 LLM 驱动的、从非结构化到结构化的自动化构建流程:
- LLM 驱动的知识抽取:系统遍历所有源文档,通过精心设计的 Prompt 指导 LLM 以 JSON 格式抽取出文中的所有实体和关系。这一步通常是并行的,以处理海量文档。
- 实体消歧与合并 (Entity Disambiguation & Merging):LLM 会对抽取出的实体进行标准化处理,识别并合并指代同一事物的不同表述(如“Apple Inc.”、“苹果公司”和“Apple”应被合并为同一个实体节点)。
- 社区检测与层级化:在所有实体和关系被导入图数据库后,系统运行社区检测算法,自动发现图中的主题簇,并生成社区节点。这些社区节点可以被赋予一个由 LLM 生成的、能够概括该社区内容的描述性名称。
- 全局与局部索引构建:最后,系统会为图中的实体、关系描述以及社区摘要分别创建向量索引和关键词索引,以支持后续的混合检索。
数据检索机制
GraphRAG 的检索是一个多层次、从宏观到微观的探索过程:
- 种子节点选取 (Seed Node Selection):当用户提出问题时,系统首先将问题向量化,在社区摘要的向量索引中进行搜索,找到与问题最相关的几个宏观主题社区。
- k-hop 扩展与邻域探索 (k-hop Expansion & Neighborhood Exploration):从选定的社区节点出发,系统开始在图上进行 k-hop 遍历,探索与这些社区直接或间接相关的实体和关系,形成一个与查询问题高度相关的“子图”。
- 聚合、摘要与上下文构建 (Aggregation, Summarization & Context Construction):系统将这个子图中的所有实体、关系、以及它们的描述性文本聚合起来。然后,通过另一个 LLM Prompt,将这些零散的图信息整合成一段或多段通顺、连贯的自然语言摘要。
- 重排与最终生成 (Reranking & Final Generation):生成的摘要作为高质量的上下文,与原始问题一起被送入最终的问答 LLM,生成精确的答案。
Mem0
流程
---
title: Mem0 数据写入与数据检索机制
---
flowchart LR
  %% 主题:Mem0 数据写入与数据检索机制
  %% 目标:层次分组 + 清晰逻辑

  subgraph WritePipeline[数据写入机制]
    W0[对话输入/事件流] --> W1[LLM 记忆写入器]
    W1 --> W2{是否值得记忆}
    W2 -- 否 --> W9[丢弃/仅保留会话上下文]
    W2 -- 是 --> W3[结构化信息抽取]
    W3 --> W4[实体与关系抽取]
    W3 --> W5[语义向量化]
    W4 --> W6[图数据库写入<br/>节点/边/关系属性]
    W5 --> W7[向量数据库写入<br/>向量/元数据]
    W3 --> W8[结构化元数据存储<br/>类型/标签/来源/时间]
    W6 --> W10[去重与合并]
    W7 --> W10
    W8 --> W10
    W10 --> W11[保留/归档策略<br/>重要性/新鲜度]
    W11 --> W12[归属绑定<br/>用户/会话/智能体]
  end

  subgraph Store[统一记忆层]
    S1[图数据库<br/>实体关系网络]
    S2[向量数据库<br/>语义嵌入索引]
    S3[结构化元数据存储]
  end

  subgraph ReadPipeline[数据检索机制]
    R0[用户问题/Agent 需求] --> R1[检索编排器]
    R1 --> R2[结构化过滤<br/>用户/类型/标签/时间]
    R1 --> R3[图关系检索<br/>路径/关系类型]
    R1 --> R4[语义相似度检索]
    R1 --> R5[关键词检索]
    R2 --> R6[候选集合]
    R3 --> R6
    R4 --> R6
    R5 --> R6
    R6 --> R7[重要性/新鲜度加权]
    R7 --> R8[关系一致性校验]
    R8 --> R9[重排与剪枝]
    R9 --> R10[上下文注入到 Prompt]
  end

  %% 存储层连接
  W6 --> S1
  W7 --> S2
  W8 --> S3

  S1 --> R3
  S2 --> R4
  S3 --> R2
数据写入机制
Mem0 的写入过程是一个智能化的过滤与评估流程:
- LLM 记忆写入器: 在每次对话交互后,Mem0 会将最新的对话片段传递给一个专门的“记忆写入器”LLM。该 LLM 的任务是分析对话,判断其中是否包含值得记忆的信息。
- 结构化信息抽取: 如果检测到可记忆内容,LLM 会将记忆抽取为结构化数据(类型、来源、上下文、标签等),并为其分配初始的重要性评分。
- 实体与关系抽取: 从记忆中识别出关键实体与关系,写入图数据库,形成可查询的关系网络。
- 语义向量化: 将记忆内容或实体描述向量化,写入向量数据库,建立相似度检索索引。
- 去重与合并: 写入前进行相似性搜索与关系校验,发现高度相似或可合并的记忆时,更新旧记忆的内容与时间信息。
- 保留/失效策略: 根据重要性与新鲜度执行归档或淘汰,维持记忆系统的质量与规模。
- 租户与主体归属: 所有记忆与用户、会话或智能体绑定,确保数据隔离与可控的权限边界。
数据检索机制
Mem0 的检索机制旨在平衡相关性、重要性和时效性,实现精准的“恰时回忆”:
混合查询:当 Agent 需要检索记忆时,它会结合多种查询方式:
- 结构化过滤:首先根据元数据进行筛选,例如“只检索该用户的、类型为‘偏好’的记忆”。
- 语义检索:将当前问题向量化,在过滤后的结果中进行向量相似度搜索。
- 关键词检索:支持对特定术语或名称的精确匹配。
重要性与新鲜度加权:检索到的结果会根据其重要性评分和新鲜度评分进行重排。这意味着,即使一个旧记忆在语义上稍微远一些,但如果它被标记为非常重要,其排名也可能高于一个非常相似但无关紧要的近期闲聊。
关系一致性校验: 对图关系检索结果进行一致性约束,确保实体与关系链路符合当前上下文。
上下文剪枝与注入:最终,排名靠前的记忆被格式化后,注入到提供给主 LLM 的 Prompt 中,作为决策的上下文依据。
OpenClaw
核心理念
使用 Markdown 文件存储原始的记忆,存放在 ~/.openclaw/workspace/MEMORY.md 和 ~/.openclaw/workspace/memory/*.md 文件中。记忆文件变更通过异步本地 SQLite 构建全文和向量索引,通过工具进行全文和向量混合检索。
整体流程
flowchart TB
  %% OpenClaw 记忆系统逻辑总览(仅一级编号)
  subgraph L0[OpenClaw 记忆系统]
    direction TB

    subgraph L1[1 记忆存储层(Markdown 真值源)]
      direction TB
      M1[MEMORY.md<br/>长期精选记忆]
      M2[memory/YYYY-MM-DD.md<br/>每日运行日志]
      M3[其他 Markdown 记忆文件<br/>projects.md / network.md 等]
    end

    subgraph L2[2 会话与加载层]
      direction TB
      S1[会话启动]
      S2[加载:今天/昨天日志]
      S3[加载:MEMORY.md(仅主私聊)]
      S4[上下文构建]
    end

    subgraph L3[3 检索与索引层]
      direction TB
      I1[分块与嵌入]
      I2[向量索引]
      I3[BM25 关键词索引]
      I4[混合检索融合<br/>Vector + BM25]
      I5[可选后处理<br/>Temporal Decay / MMR]
    end

    subgraph L4[4 工具接口层]
      direction TB
      T1[memory_search<br/>语义召回片段]
      T2[memory_get<br/>按路径/行号精读]
    end

    subgraph L5[5 策略与维护层]
      direction TB
      P1[写入策略<br/>长期信息→MEMORY.md<br/>当日上下文→daily log]
      P2[自动记忆刷新<br/>compaction 前提醒写入]
      P3[权限边界<br/>群聊禁加载长期记忆]
    end

    subgraph L6[6 可选后端与加速]
      direction TB
      O1[sqlite-vec 加速]
      O2[QMD sidecar<br/>BM25 + 向量 + 重排]
      O3[远程/本地嵌入提供方]
    end
  end

  %% 主流程:会话 → 上下文 → 先搜后读
  S1 --> S2 --> S4
  S1 --> S3 --> S4
  S4 --> T1 --> T2
  T2 --> S4

  %% 索引与检索:Markdown → 分块/索引 → 融合/后处理 → 搜索
  M1 --> I1
  M2 --> I1
  M3 --> I1
  I1 --> I2
  I1 --> I3
  I2 --> I4
  I3 --> I4
  I4 --> I5
  I5 --> T1

  %% 写入与维护:策略 → 落盘;压缩前刷新;隐私边界约束加载
  P1 --> M1
  P1 --> M2
  P2 --> M1
  P2 --> M2
  P3 -.-> S3

  %% 可选加速/后端:影响索引与检索
  O1 -.-> I2
  O2 -.-> I4
  O3 -.-> I1
存储形态:Markdown 作为唯一真值源
记忆数据以纯 Markdown 文件落盘,磁盘文件是唯一真值源
模型只“记住”被写入磁盘的内容,不依赖隐藏的外部数据库
默认工作区包含两类关键文件:
MEMORY.md:长期精选记忆,记录偏好、长期事实、关键决策与稳定约束memory/YYYY-MM-DD.md:每日日志,追加式记录当天的上下文与进展
记忆层级与加载策略
- 记忆分为长期记忆与短期工作记忆两层
- 会话启动时优先加载最近的 daily log(通常为今天与昨天),保证近期上下文连续
- MEMORY.md 作为“长期事实”仅在主私聊会话加载,避免群聊场景暴露隐私
- 这种分层可以在上下文窗口有限的情况下兼顾稳定知识与最新进展
记忆工具接口
memory_search:从已索引的记忆片段中召回相关内容
- 输入:查询文本
- 输出:片段内容、来源文件、行号范围、分数等元信息
- 用途:语义回忆,适合找“相关内容”
memory_get:按路径与行号读取指定记忆内容
- 输入:文件路径、起始行与行数
- 输出:指定范围的原始文本
- 用途:精准读取,适合“定位某个文件段落”
两者搭配形成“先搜后读”的工作流:先用 memory_search 确定位置,再用 memory_get 精确读取
索引与检索机制
向量索引
- 对 Markdown 内容进行分块并生成向量嵌入
- 通过向量相似度实现语义匹配
混合检索
- 将向量语义相似度与 BM25 关键词匹配结合
- 既能理解“语义相近”,也能精准命中错误码、标识符等高信号词
自动记忆刷新(防丢失)
- 会话接近自动压缩(compaction)时触发一次静默“写入提醒”
- 目的:在压缩之前将可复用的长期信息落盘,避免“上下文被压缩后丢失”
- 这使记忆写入与会话压缩解耦,提升长期可用性